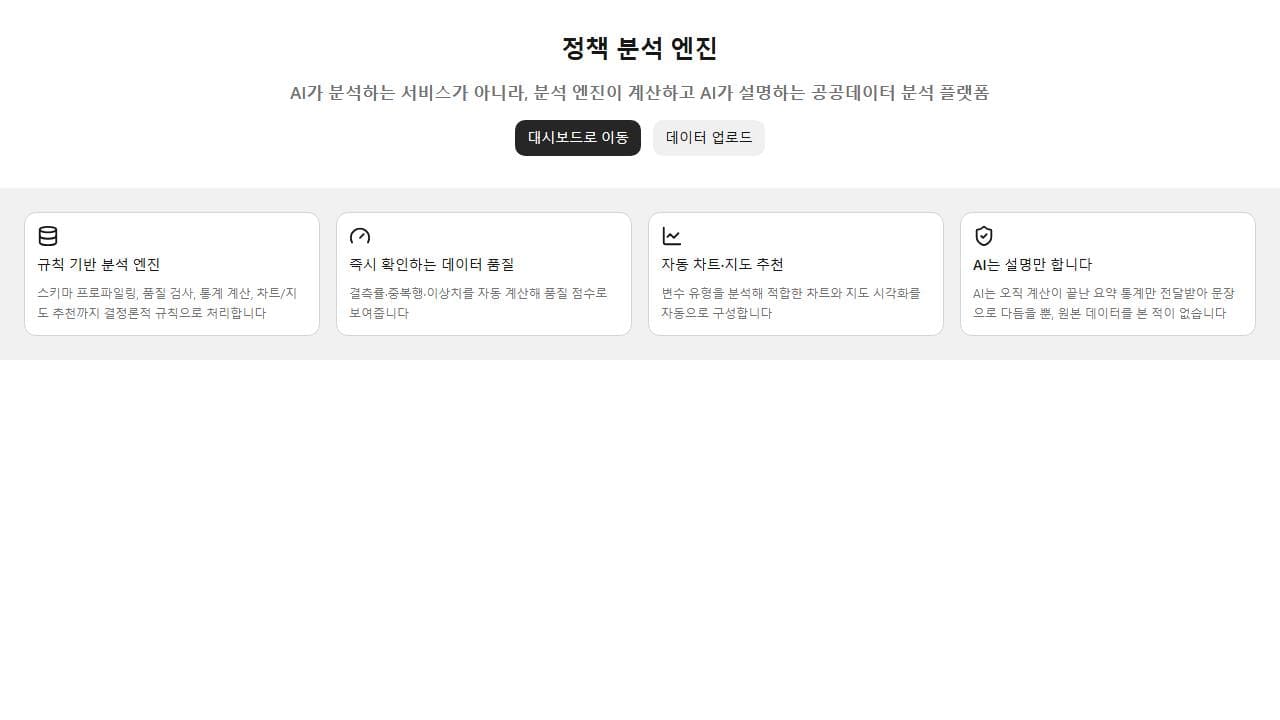
정책 분석 엔진
AI가 분석하는 도구가 아니라, 엔진이 계산하고 AI는 설명만 하는 공공 분석 도구
NaDa· 게스트2026년 7월 12일조회 12
story · how it was built
설명
무엇을 (문제·대상)
공공 분석에 LLM을 쓸 때 가장 위험한 건 계산까지 맡기는 것입니다. 같은 질문에 다른 숫자가 나오면 그 결과는 보고서에 쓸 수 없습니다. 이 도구는 역할을 나눕니다. 숫자는 규칙 기반 엔진이 계산하고, AI는 계산이 끝난 요약 통계만 받아 문장으로 다듬습니다. AI는 원본 데이터를 본 적이 없습니다.
주요 기능
- 데이터 업로드 — 파일을 올리면 스키마 프로파일링부터 시작합니다.
- 품질 검사 — 결측률, 중복행, 이상치를 자동 계산해 품질 점수로 보여 줍니다. 분석 전에 이 데이터가 쓸 만한지 먼저 알려 줍니다.
- 규칙 기반 통계 계산 — 산식이 코드에 고정돼 있어 같은 입력에 같은 결과가 나옵니다.
- 자동 차트·지도 추천 — 변수 유형을 분석해 적합한 시각화를 자동으로 구성합니다.
- AI 해설 — 계산 결과에 대한 해석 문장을 만듭니다. 숫자는 만들지 않습니다.
어떻게 만들었는가 (과정·도구 활용)
설계에서 가장 중요한 결정은 「AI가 닿는 표면을 하나로 좁힌다」였습니다. 여러 화면에서 각자 모델을 부르면 어디서 무엇이 넘어갔는지 추적이 불가능해집니다. 접점을 한 곳으로 모으고, 그 자리에서 넘길 수 있는 필드를 화이트리스트로 제한했습니다. 그래서 원자료가 통째로 모델에 흘러갈 경로 자체가 없습니다.
시각화도 사용자가 차트 종류를 고르게 하지 않고, 변수 유형에서 결정론적으로 추천합니다. 잘못된 차트로 잘못된 인상을 주는 것이 분석 도구에서 가장 흔한 실패이기 때문입니다.
한계·다음
- 산식이 코드에 고정돼 있어 새 지표를 추가하려면 코드를 고쳐야 합니다. 대신 결과의 재현성을 얻었습니다.
- 해설 문장의 품질은 모델에 의존합니다. 다만 틀려도 숫자는 안 바뀝니다.
journey · lessons
과정 · 배운 점
본문 = 무엇·기능·사용법. 여기 = 시간순 여정 + 다음에 남긴 교훈.
LLM을 쓰는 공공 도구에서 가장 먼저 정해야 할 것은 「AI가 무엇을 하지 않는가」였습니다. 계산을 맡기지 않기로 정하고 나니 검증이 단순해졌습니다. 엔진은 테스트로 재고, AI는 문장만 보면 됩니다.
모델에 넘기는 필드는 열거가 아니라 화이트리스트로 선언해야 합니다. 「이건 빼자」로 관리하면 필드가 늘 때마다 빠뜨립니다.
분석 전에 품질 점수를 먼저 보여 주는 것이 결과를 예쁘게 만드는 것보다 중요했습니다. 결측이 많은 데이터로 낸 그럴듯한 차트가 가장 위험합니다.
피드백 원함 · 개선 제안 · 스택·도구 조언 · 질문